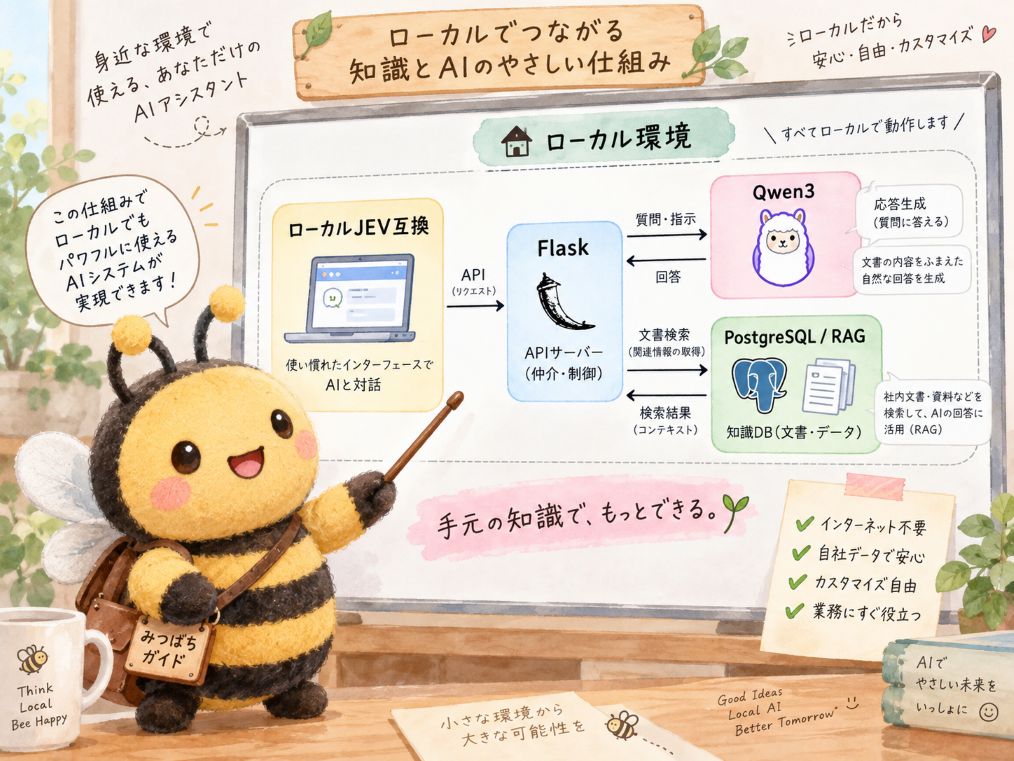
ローカルJEV互換 + Qwen3 + Flask + PostgreSQL/RAG
Ubuntu / Mac の両方で動かす、ローカル判断AI基盤の構想。Jevの「文章を生成するAI」ではなく「ソフトウェアが使える判断を返すAI」という考え方を、Qwen3とRAGで実装する。
1. そもそもJEV(Jev)とは何か
Jev はTypeSafe AIが2026年9月に公開した「System One Model」の最初のモデルです。通常のLLMが文章を生成することを主目的にするのに対し、Jevは入力された状態を見て、型付きの判断と確率を返すことを主目的にしています。
通常のLLM
説明、要約、会話、文章作成などに強い一方、ソフトウェアから見ると返答文を再解釈する必要があります。
Jev型
「分類」「Yes/No判断」「段階評価」を、アプリがそのまま処理できる構造化データとして返します。
Jevの3種類の判断
| 種類 | 意味 | 例 | 想定出力 |
|---|---|---|---|
| Choice | 候補の中から分類・選択 | 問い合わせ内容は「故障 / 契約 / 苦情 / その他」のどれか | 故障 0.82 / 契約 0.08 / 苦情 0.07 / その他 0.03 |
| Noul | 命題が成立する可能性 | この報告は緊急対応が必要か | 0.91 |
| Score | 定義した尺度上で評価 | 損傷の重要度を「軽微 / 中 / 大 / 緊急」で評価 | 「大」中心の分布 |
2. 今回作るものは「Jevそのもの」ではなく「Jev互換ローカル実装」
TypeSafe公式はPython SDKに加え、LLM APIを使ってJev互換の評価インターフェースを実現する system-one-adapter-python を公開しています。この考え方をローカルQwen3に適用します。
Choice / Noul / Score と互換性のある判断APIを作ります。したがって公式Jevと同一の確率校正・速度・精度を保証するものではありません。アプリ側ではJev風の共通APIだけを見るようにし、将来は次のように差し替えられる構造にします。
3. 提案する全体構成
基本方針:LLMに全部を任せない。RAGは根拠検索、JEV互換層は判断、Pythonは確定処理を担当する。
4. Ubuntu / Mac を同一設計にする方法
| レイヤー | Ubuntu | Mac | 共通化 |
|---|---|---|---|
| Web API | Flask + gunicorn | Flask(開発)/ gunicorn | 同一Pythonコード |
| DB / RAG | PostgreSQL + pgvector | PostgreSQL + pgvector | 同一スキーマ |
| LLM | Qwen3 GGUF + llama.cpp(CUDA/CPU) | Qwen3 GGUF + llama.cpp Metal、またはMLX | OpenAI互換ローカルHTTP APIを境界にする |
| JEV互換 | Flask内の共通Decision Engine。Choice / Noul / ScoreをJSONで定義 | 完全共通 | |
| Embedding | 日本語対応の多言語Embeddingモデルをローカル実行 | 完全共通 | |
5. 処理の流れ
例:設備点検
{
  "state": {
    "report": "擁壁に新しい斜めクラックを確認。雨天後に湧水あり。",
    "rag_context": [
      "維持管理基準 4.2: 新規クラックと湧水の併発時は詳細確認...",
      "過去点検: 前回はクラックなし..."
    ]
  },
  "questions": {
    "category": {
      "type": "choice",
      "criteria": ["経過観察", "再点検", "専門家確認", "緊急対応"]
    },
    "urgent": {
      "type": "noul",
      "instruction": "早急な対応が必要か"
    },
    "severity": {
      "type": "score",
      "scale": ["軽微", "中", "大", "緊急"]
    }
  }
}
結果が urgent = 0.92 なら、「0.85以上は担当者へ通知」のようにPython側で明示的なルールを実行できます。判断と処理を分離するため、業務システムとして監査しやすくなります。
6. この構成で何ができるか
文書の自動振り分け
メール、報告書、問い合わせ、点検記録を複数カテゴリへ分類。確信度が低いものだけ人に回す。
RAG根拠付き判定
社内規程・マニュアル・過去記録を検索し、それを根拠状態として判断モデルへ渡す。
異常・緊急度判定
設備報告、災害情報、監視イベントを「通常 / 注意 / 警告 / 緊急」などに評価。
ワークフロー自動分岐
確率と閾値を使い、承認、再確認、通知、保留などの処理を自動分岐。
LLM回答の検査役
別のLLMが作った回答について、根拠不足、要修正、カテゴリ適合などを第二段階で判定。
検索結果の再ランキング
RAGで取得した複数資料を、質問への適合度で再評価し、上位だけを生成LLMへ送る。
センサー+文章の判断
数値計算はPython、ログや状態説明の意味判断はQwen3に担当させ、最終分岐を統合。
CSV / JSON自動処理
分類結果をJSON化し、CSV出力、DB更新、帳票生成、別システムへの連携に利用。
オフライン業務支援
モデル・DB・RAGを端末またはLAN内サーバに置き、機密情報を外部クラウドへ送らない構成が可能。
7. 特に相性が良い使い方
| 用途 | RAG | JEV互換 | Python |
|---|---|---|---|
| 点検・診断支援 | 基準書・過去履歴 | 状態分類・危険度 | 閾値、計算式、通知 |
| 問い合わせ処理 | FAQ・契約・製品情報 | 種別・緊急性 | 担当振分け |
| 防災支援 | 地域資料・行動基準 | 状況・優先度 | ルール判定、警告 |
| 設計・施工記録 | 設計書・写真メタ情報 | 不足情報・確認要否 | 検査項目生成 |
| AIエージェント | 業務知識 | 次に行う行動の選択 | 実際のAPI・機器操作 |
8. 通常の「ローカルLLM + RAG」より何が増えるのか
従来
RAGで資料を探してQwen3へ渡し、最終的に文章で回答させる。
RAG → Qwen3 → 「確認が必要と思われます」
JEV互換レイヤー追加後
文章回答とは別に、アプリが利用できる判断を返す。
RAG → Qwen3 Decision
→ {
  "action": "expert_review",
  "probability": 0.91
}
→ Pythonで処理
9. 実装予定のAPI
| Endpoint | 役割 |
|---|---|
POST /api/systemone | JEV互換のChoice / Noul / Score判断 |
POST /api/rag/search | pgvector類似検索 |
POST /api/rag/ingest | 文書登録、チャンク化、Embedding生成 |
POST /api/ask | 通常のRAG + Qwen3文章回答 |
POST /api/decide | RAG検索を含む業務判断の一括実行 |
GET /api/decisions/<id> | 判断履歴、確率、使用根拠の確認 |
GET /healthz | Flask / DB / LLM / RAGの死活確認 |
10. 判断履歴を保存する理由
JEV型の仕組みでは、単に最終回答を保存するだけでなく、何を見て、どの選択肢を何%と評価し、どの閾値によって処理したかを記録できます。
decision_log
├─ id
├─ created_at
├─ model
├─ state_hash
├─ retrieved_document_ids
├─ question_type
├─ choices / score
├─ probabilities
├─ selected_action
├─ threshold
└─ execution_result
これにより、後日「なぜこの処理になったのか」を追跡しやすくなり、精度改善用の評価データにもできます。
11. 初期構成案
| 項目 | 初期採用 | 理由 |
|---|---|---|
| LLM | Qwen3 4B〜8B級 GGUF | ローカル運用と日本語性能のバランスを取りやすい |
| Inference | llama.cpp server | Ubuntu CUDA / CPU、Mac Metalで共通化しやすい |
| Mac高速化候補 | MLX | Apple Silicon向けに後から追加可能 |
| API | Flask | 既存Python資産・業務モジュールと統合しやすい |
| DB | PostgreSQL 16+ / pgvector | RAG・業務DB・監査ログを一本化 |
| Embedding | 日本語対応多言語モデル | 完全ローカルRAG |
| JEV互換型 | Choice / Noul / Score | 公式Jevの考え方に合わせる |
12. 精度を上げるための二段階構成
初期版はQwen3に確率分布を構造化出力させます。その後、よりJev型に近づけるために候補トークンのlogits / logprobsを直接利用する方式を追加できます。
| 段階 | 方式 | 長所 | 注意 |
|---|---|---|---|
| Phase 1 | Qwen3 + JSON確率出力 | 早く実装でき、機種差が少ない | 自己申告確率なので校正が必要 |
| Phase 2 | 候補logitsから確率算出 | 生成文に依存せず高速化しやすい | トークナイズや候補設計の検証が必要 |
| Phase 3 | 検証データによるCalibration | 0.8なら実際にも約80%正しい、に近づける | 用途別の正解データが必要 |
13. 実装上の重要原則
AIに計算させない
確定的な数式、日付計算、閾値比較はPythonで処理。
AIに勝手な候補を作らせない
Choiceはアプリ側で候補を定義し、その中だけから選択。
低確信度は人へ戻す
「不明」を無理に自動化せず、閾値以下は確認待ちへ。
14. 最終的に目指す形
                      ┌──────── 通常の回答 ────────┐
ユーザー / センサー → RAG → Qwen3               │
                      │                           ↓
                      └→ JEV互換 Decision → Python → 実行
                              │
                              ├→ 自動処理
                              ├→ 再検索
                              ├→ 別LLMへ依頼
                              ├→ 人へ確認
                              └→ 保留
「話すAI」と「判断するAI」を分け、その判断結果をPythonが安全に実行する。 これが今回のローカルJEV互換基盤の中心です。
15. 参考情報(2026-09-21確認)
- TypeSafe AI — Introducing System One Models & Jev
https://typesafe.ai/blog/introducing-system-one-models-and-jev - TypeSafe AI — Python SDK
https://github.com/typesafe-ai/typesafe-sdk-python - TypeSafe AI — System One Adapter
https://github.com/typesafe-ai/system-one-adapter-python - GitHub Next — LocalJev(ローカル互換実装の研究例)
https://github.com/githubnext/localjev - OpenJev — Qwen3 / MLXによるローカル実装例
https://github.com/zhihz/openjev
Jevは公開直後の技術であり、SDK、モデル、ローカル互換実装は今後変化する可能性があります。本資料では「公式Jev」と「Qwen3等によるJev互換実装」を明確に区別しています。
No responses yet