Product / LLM・マルチモーダルAI
大規模言語モデルLLM構築支援
LLM、翻訳、RAG生成から、その先のマルチモーダルAI活用まで
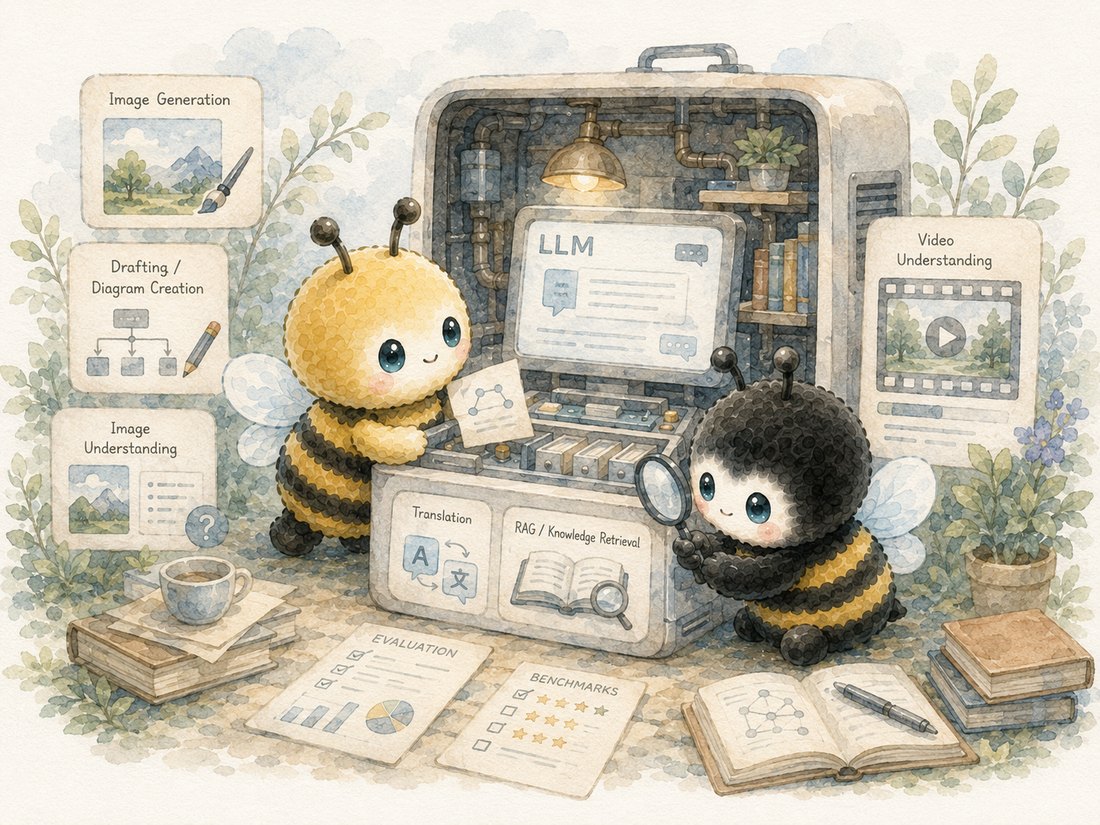
大規模言語モデル(LLM)の導入・構築・運用を支援します。文章生成や対話だけでなく、翻訳、RAG生成、ナレッジ活用を実務で使える形に整えます。さらに、画像生成・作図・画像理解・動画理解といった次の領域についても、実用性を見極めるためのベンチマークを進めています。
主な機能
LLMを「試す」だけで終わらせず、実務で使える形へ落とし込むための支援領域です。
LLM構築支援
用途整理、モデル選定、プロンプト設計、ローカル実行、クラウド利用、運用設計まで支援します。
翻訳
多言語翻訳、技術文書の翻訳、専門用語を含む文章の整形など、実務向けの翻訳フローを整えます。
RAG生成
社内文書、PDF、技術資料、ナレッジを検索・参照しながら回答するRAG環境を構築します。
評価・ベンチマーク
精度、速度、コスト、運用性を確認し、使えるモデルと使いにくいモデルを現実的に見極めます。
その先のAI活用もベンチマーク中
LLMの先にあるマルチモーダルAI活用についても、実務適用を見据えて検証しています。
画像生成
説明文やアイデアから、Web素材、アプリ素材、説明用イラストを生成する用途を検証中です。
作図・図面生成
CAD、構成図、説明図、JSONベースの作図指示など、図面化支援の可能性を検証しています。
画像理解
画像内の状況、対象物、構造、異常箇所を読み取り、説明や判定に使う流れを評価しています。
動画理解
動画から場面、動作、変化、異常の兆候を読み取る活用について、実用性をベンチマーク中です。
説明
主な用途、導入時の確認ポイント、活用場面を整理しています。
LLM導入を現場に合わせる
LLMは導入しただけでは業務改善になりません。何を任せるか、どの情報を参照させるか、どこまで自動化するかを整理し、現場で使える形に設計します。
翻訳とRAGを中核に
翻訳とRAGは、実務で効果を出しやすい領域です。社内資料や技術文書を活用し、必要な情報を探し、整理し、わかりやすく返す仕組みを構築します。
マルチモーダルAIへの拡張
画像生成、作図、画像理解、動画理解は、今後の業務支援で重要になります。派手なデモではなく、精度・再現性・運用性を見ながらベンチマークしています。
小さく試して、育てる
いきなり大規模な仕組みにせず、小さな検証から始めます。結果を見ながらデータ、モデル、プロンプト、RAG設計を改善し、使えるAIへ育てます。